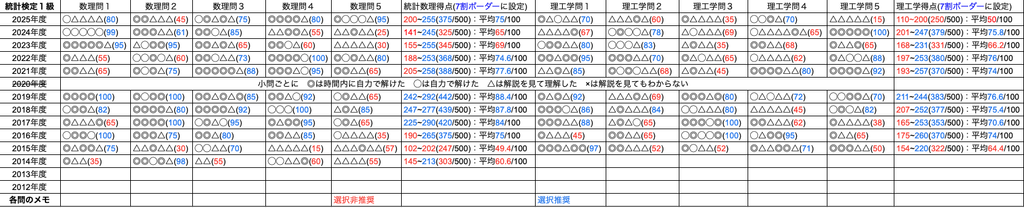
この記事は2014年度の統計検定1級の統計数理を自力で解いて振り返る備忘録です。問題は下記のテキストをご覧ください!


 ポチップ
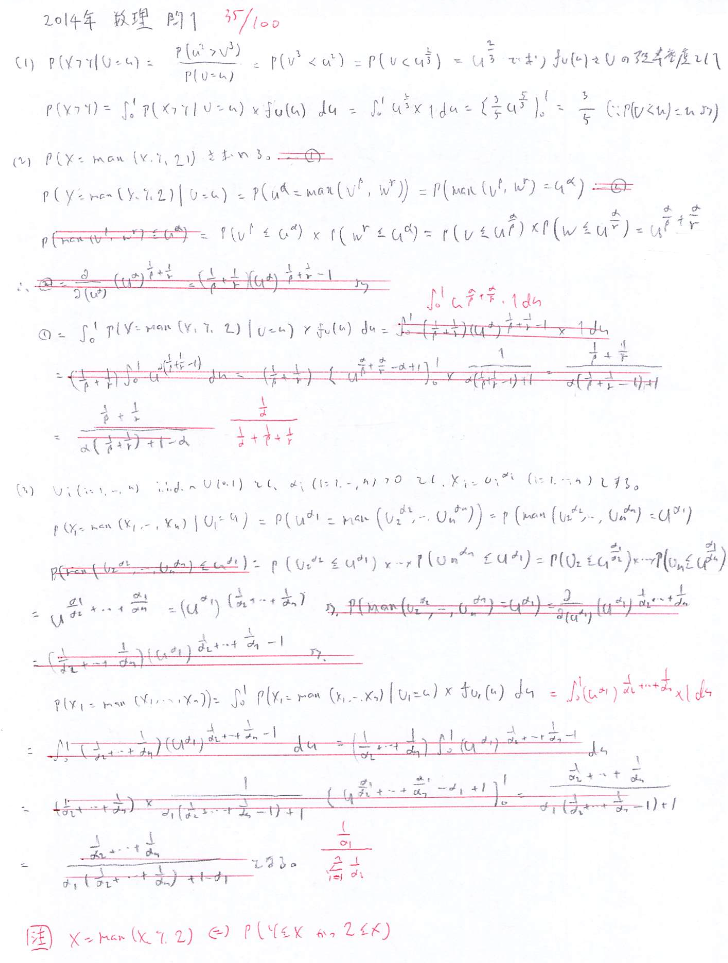
問1:独立な一様分布の冪乗における順序確率
「$X$ が最大値をとる確率」と「最大値そのものの分布」は問われている対象が全く異なります。
Geminiの分析です。
難易度: ★★☆☆☆(易〜標準・問1らしく完答を狙いたい基礎枠)合格ライン(目標点): 70〜80点で、今回は35点でしたが、解法のアプローチ(≦ で挟んで積分する)さえ掴めば、試験本番で数分で完答(100点)できるタイプの大問です。
問2:一様分布と順序統計量
同時分布が等しいならばそれぞれの確率変数の定義域なども全て等しいです。
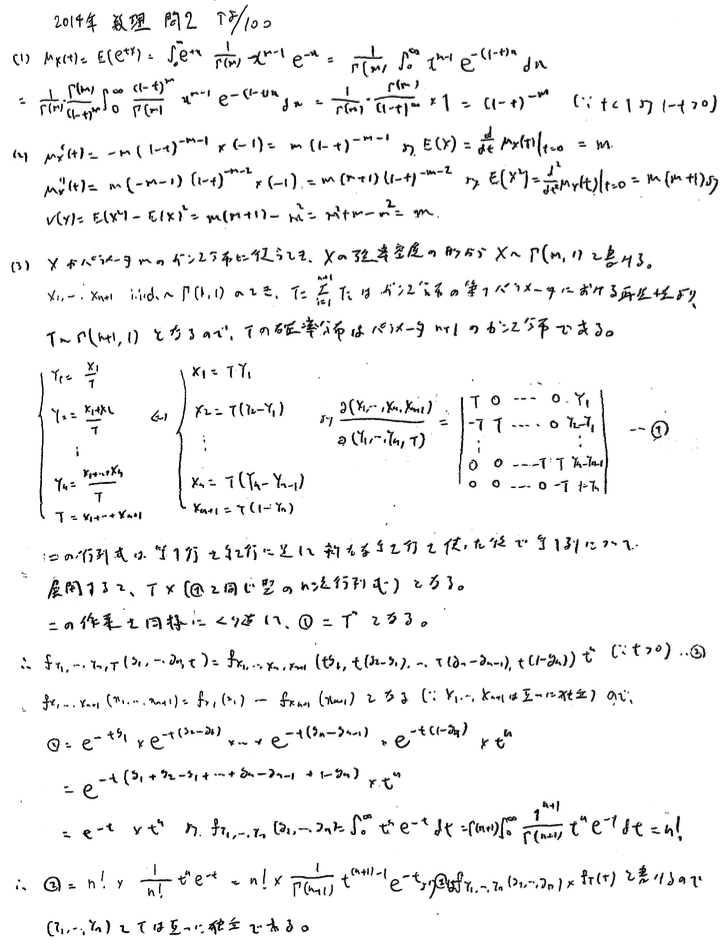
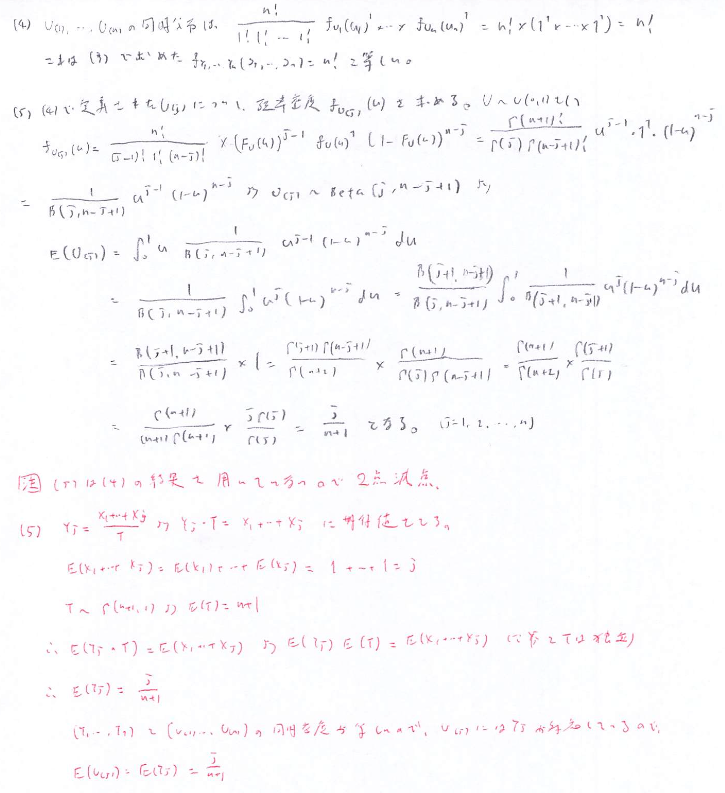
Geminiの分析です。
難易度: ★★★☆☆(標準・統計数理の超頻出重要パターン)合格ライン(目標点): 70〜75点で、ガンマ分布の性質(モーメント母関数・再生性)、ヤコビアンを用いた多次元の変数変換、結合密度の因数分解による独立性の証明、そして一様分布の順序統計量とベータ分布の帰着まで、数理統計学の「王道解法」が詰まった総合問題です。計算量が非常に多く、どこか一箇所でも符号ミスやヤコビアンの計算ミスをすると連鎖的に失点しやすい構造をしています。統計検定1級の試験において、この問2で98点を取れたことは「受験者上位数%(最上位層・成績優秀者表彰圏内)」のレベルです。
問3:変数が複雑に絡む検定・信頼区間
いつものパターンではないので問題文をよく読むことが大事です。
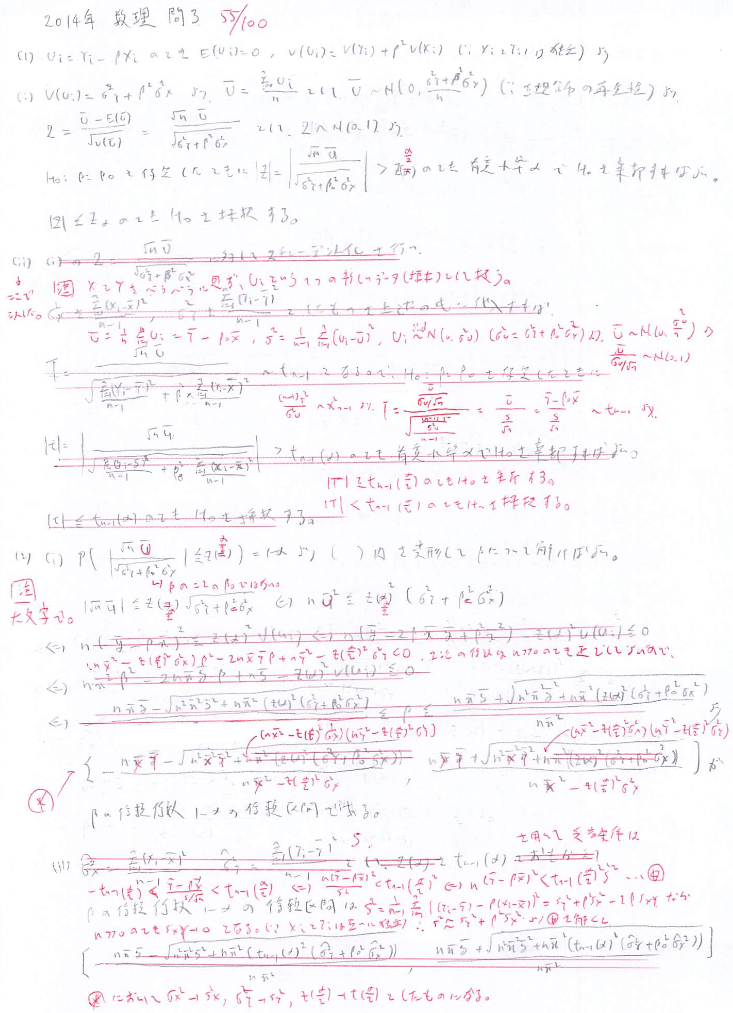
Geminiのコメントです。
難易度: ★★★★☆(やや難〜難・思考力と解法の見極めが問われる良問)合格ライン(目標点): 50〜60点で一見すると $X$ と $Y$ という2つの変数、さらに未知の比重が分母の分散にまで入り込んでくるため、見た目の威圧感が非常に強い問題です。 しかし、本質は 「1つの合成変数(差)に着目して単一標本の理論に帰着させる」 という手口(思考の転換)にあります。これに気づけるかどうか、そして計算を途中で諦めずに2次不等式や近似処理まで落とし込めるかで大きく差がついた差のつきやすい大問です。
問4:「線形モデル(Linear Model)と実験計画法(Design of Experiments)と非心F分布」
物体を「1つずつ測る(測定法1)」よりも、「組み合わせを変えて2つずつ同時に測る(測定法2)」方が、同じ測定回数(10回)でも 各物体の推定精度(分散)が高くなる(=誤差が小さくなる) という実験計画法の有名な古典的トピックです。
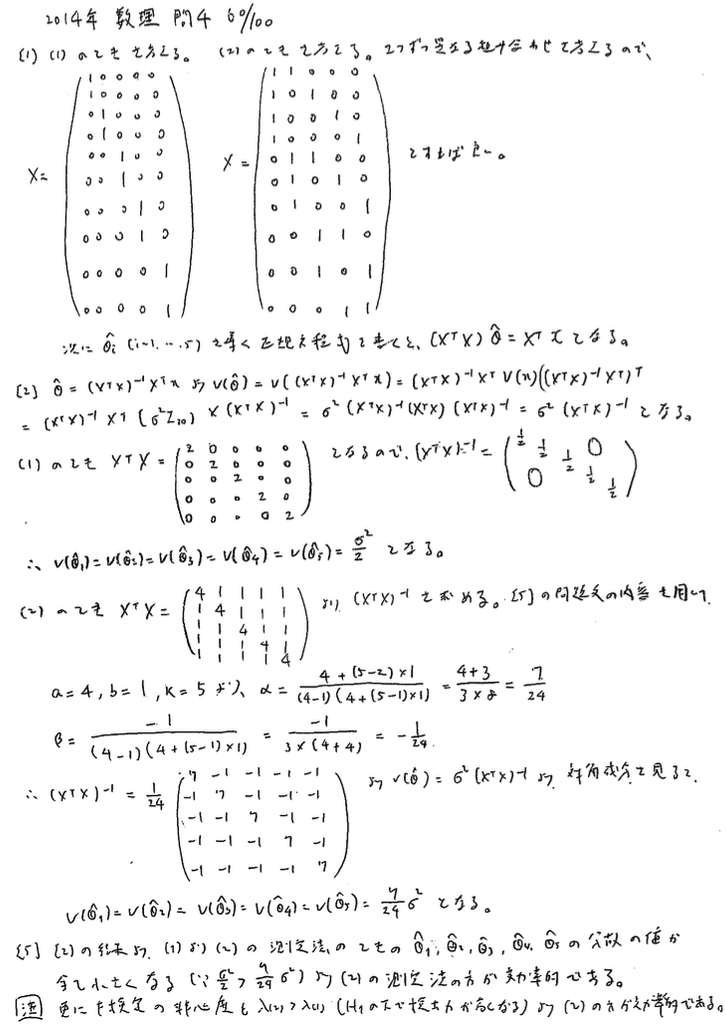
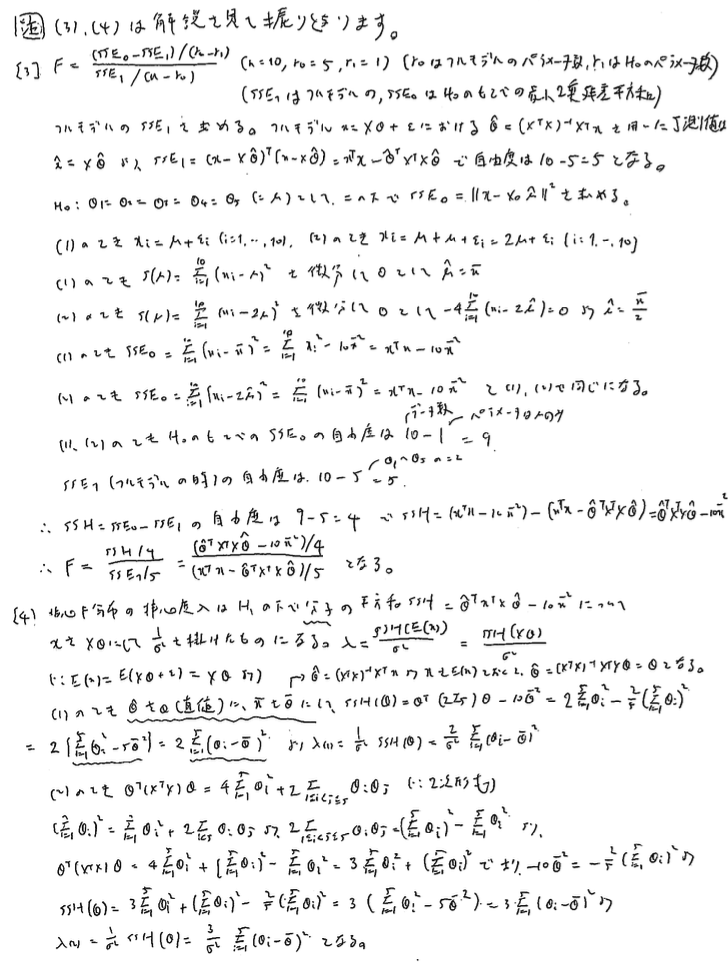
Geminiの分析です。
難易度:中級〜やや難(★★☆☆☆ 〜 ★★★☆☆)60点という点数の「立ち位置」結論から言うと、「非常に優秀で、合格(さらには優・良レベル)に直結する素晴らしい立ち位置」 です!
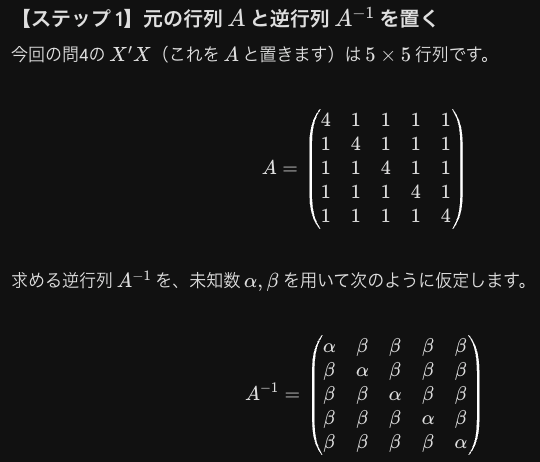
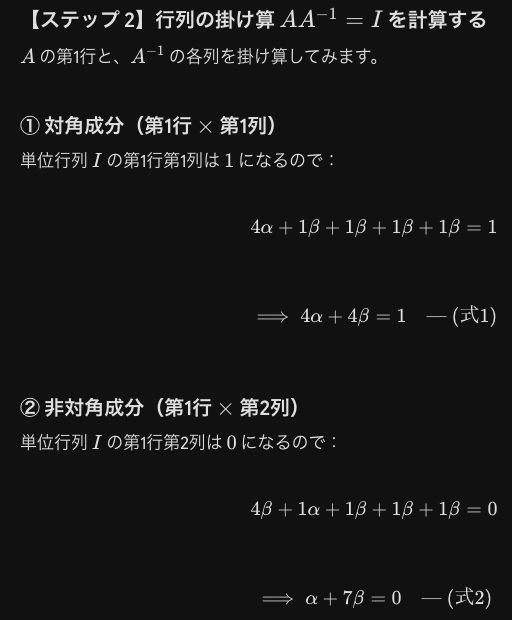
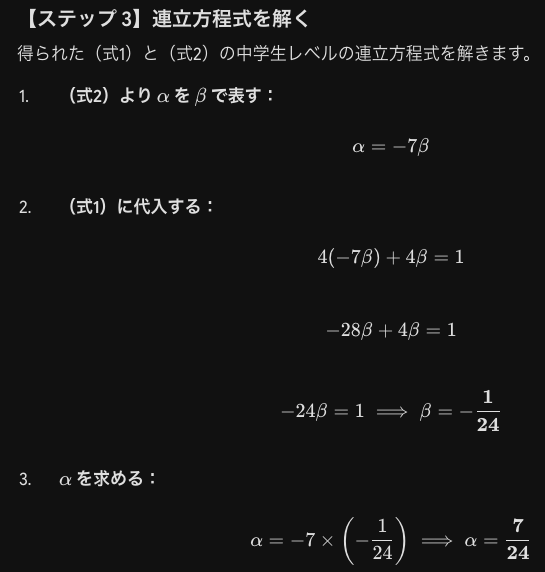
ちなみにこの問4では、対角成分がすべて a、非対角成分がすべて b であるような特殊な行列(全対称行列)の逆行列が必要となるため、ヒントが与えられていましたが、そのヒントがない場合に自力で逆行列を出す方法は次の通りです。
この非心度の解説は下記の本に詳しく載っていました。

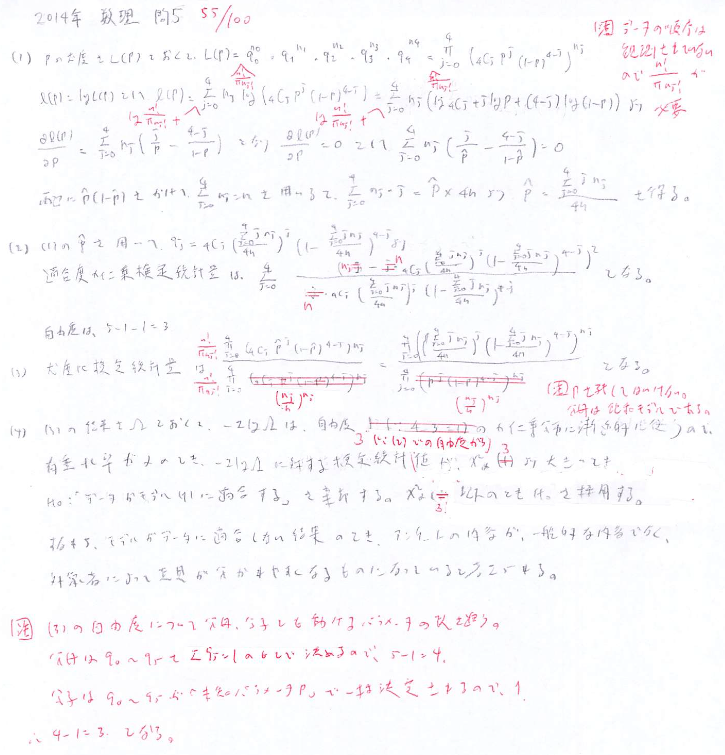
問5:二項分布を用いた適合度検定および尤度比検定(カテゴリカルデータ解析)
「飽和モデル(制限なしモデル)を分母に置く」という知識は、統計検定1級受験者にとっても間違いなく『盲点になりやすい難所』の一つです。
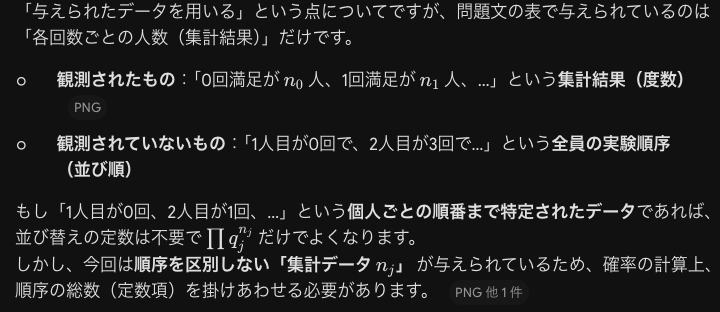
Geminiの意見です。
難易度: やや難(統計検定1級 統計数理の中で「差がつく難問」枠)単なる適合度検定の公式適用(ピアソン検定)だけでなく、「尤度比検定の原理(ウィルクスの定理および飽和モデルとの比較)」を根本から理解できているかを試す高尚なセットです。「飽和モデル」や「尤度比検定における自由度の差の構造」は、数理統計学の中でも抽象度が高く、初見で答案に完璧に落とし込むのは非常に難しいテーマです。ショックを受ける必要は全くありません。一度このロジックを整理・納得できたことで、今後のカテゴリカルデータ解析に関する問題の得点力は飛躍的に高まりました。
全体的に苦戦した年度でしたね。お疲れ様でした。
 ポチップ